
Arhitectura medallion în Microsoft Fabric: lecții învățate
Arhitectura medallion în Microsoft Fabric: lecții învățate
O prezentare practică a migrării unei platforme de date mai vechi către o arhitectură medallion în Fabric: cu ce lucram înainte, de ce a fost necesară schimbarea și cum am construit de această dată o soluție mai bună.
Microsoft Fabric a schimbat modul în care construim platforme de date peste Power BI. Înainte de Fabric, parcursul obișnuit era simplu: conectai o sursă de date, o încărcai într-un semantic model și construiai rapoartele. Power Query pentru transformări, DAX pentru măsuri și gata.
Fabric a introdus un strat nou între date și raport și, odată cu acesta, un set complet diferit de instrumente și concepte: Lakehouses, Warehouses, Notebooks, Pipelines și semantic models care se conectează la tabele Delta în locul seturilor de date importate. Dintr-odată, construirea unei soluții Power BI bune nu mai ținea doar de DAX și data modelling. Trebuia să înțelegem unde se află datele, cum circulă și cine le procesează înainte să ajungă într-o vizualizare.
Am întâlnit această schimbare într-un proiect real: o platformă de date mai veche, construită în Microsoft Fabric, care deservea echipe interne și clienți externi prin rapoarte Power BI. Când proiectul era la început, am construit ceea ce avea sens. Pe măsură ce a crescut, am început să-i simțim limitele. Aceasta este povestea a ceea ce am construit, a ceea ce nu ne-a mai fost suficient și a modului în care am reproiectat platforma fără să aruncăm ceea ce funcționa deja.
Decizia | Ce doream să obținem
Doream să conectăm semantic model prin Direct Lake, pentru date live fără actualizări programate. Doream mai puține straturi de transformare, astfel încât logica de business să existe și să poată fi testată într-un singur loc. Doream să susținem corect Power BI Embedded, ceea ce impunea un control mai strict asupra mediilor și deployment-urilor. Și doream ca platforma să se poată scala — cu mai multe surse de date, rapoarte și utilizatori — fără ca fiecare element nou să multiplice complexitatea.
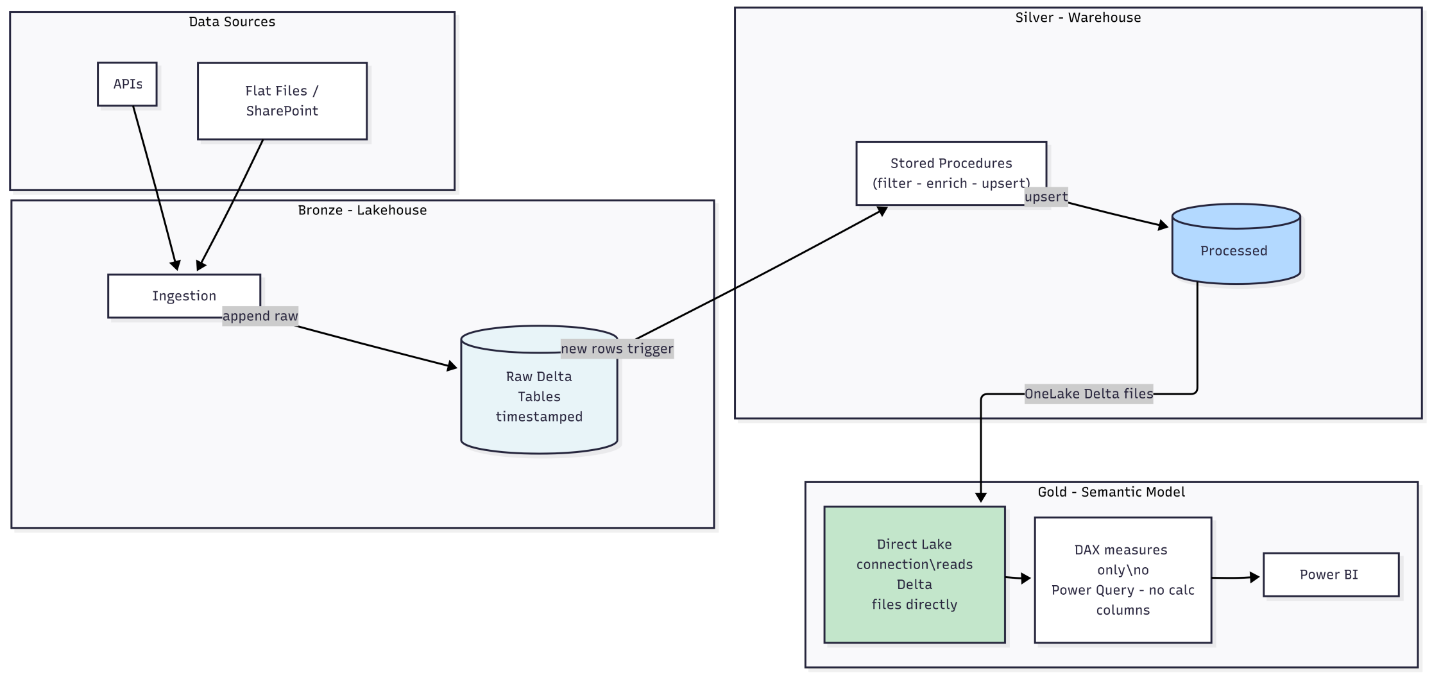
Odată stabilite aceste obiective, arhitectura aproape că s-a proiectat singură. Pentru Direct Lake sunt necesare tabele Delta în OneLake. Pentru tabele Delta curate și validate este necesar un strat de transformare care rulează înainte ca datele să ajungă la model. Pentru a controla acest strat de transformare este necesară o delimitare clară între ingestia datelor brute și datele procesate. Acesta este modelul medallion: Bronze pentru date brute, Silver pentru date procesate și Gold pentru semantic model.
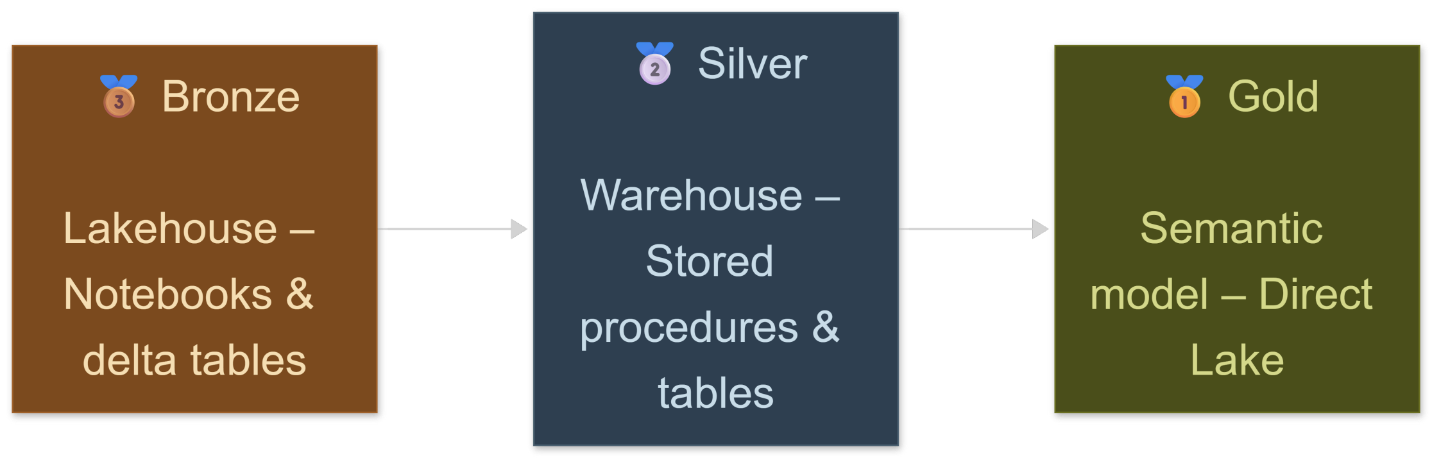
Un proof of concept rapid a confirmat că soluția funcționa de la un capăt la altul. Apoi au venit datele reale.
Înainte | Ce aveam
Vechea arhitectură avea un flux clar:
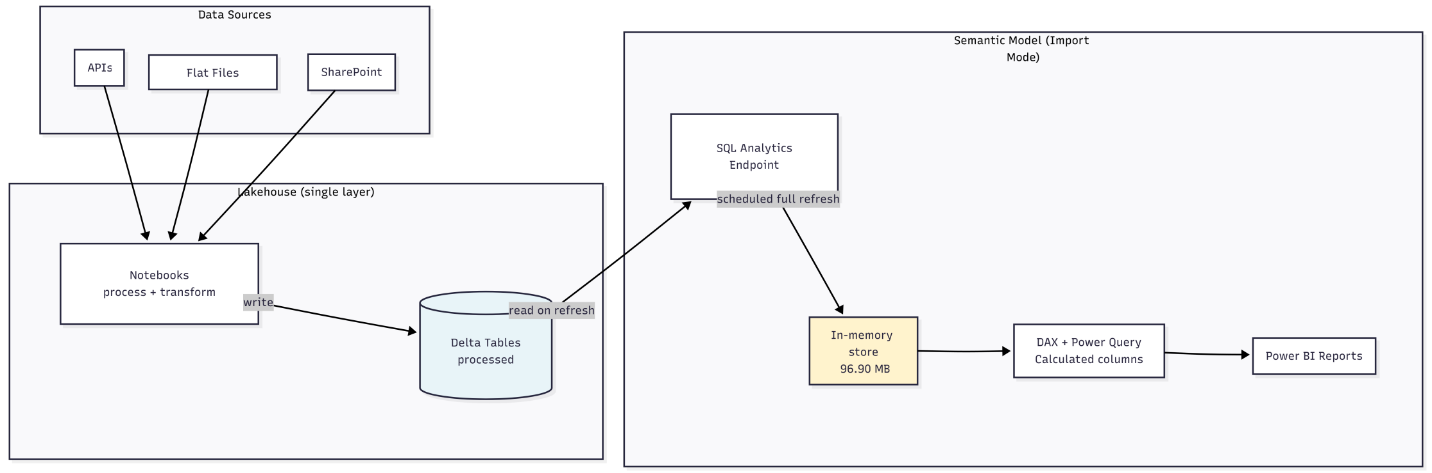
Surse de date (API-uri, fișiere simple, exporturi SharePoint) → Notebooks → Tabele procesate în Lakehouse → SQL Analytics Endpoint → Semantic model în import mode → Rapoarte
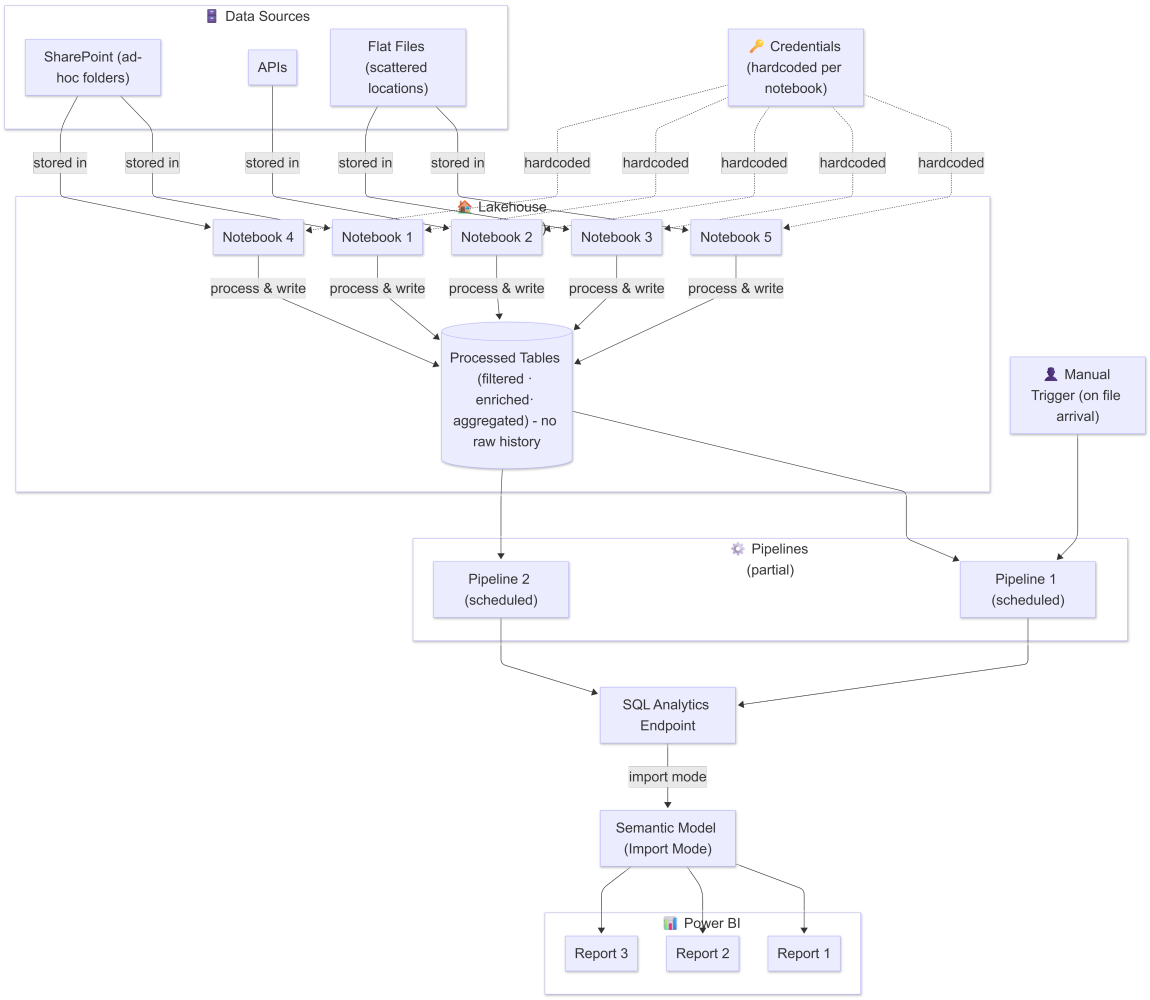
Notebook-urile gestionau împreună ingestia și procesarea, deoarece aceasta era abordarea cea mai practică atunci când proiectul era mai mic. Semantic model în import mode era abordarea standard înainte ca Direct Lake să devină o opțiune realistă. Logica de transformare era răspândită între notebook-uri, Power Query și DAX, deoarece fiecare strat rezolva o problemă reală în momentul în care fusese introdus.
Soluția funcționa. Platforma a oferit valoare reală unor utilizatori reali pentru o perioadă semnificativă. Dar nevoile noastre s-au schimbat, iar ambiția a crescut. Aveam nevoie de date live, de o guvernanță mai strictă și de spațiu pentru a scala raportarea fără să multiplicăm complexitatea.
Înainte
După
Un singur strat lakehouse, fără istoric al datelor brute
Credentiale hardcodate în fiecare notebook
Strategie mixtă de trigger-e (programate + manuale)
Import mode prin SQL Analytics Endpoint
Logică de transformare împărțită între notebook-uri, Power Query și DAX
Fără posibilitate de recuperare pentru unele surse de date
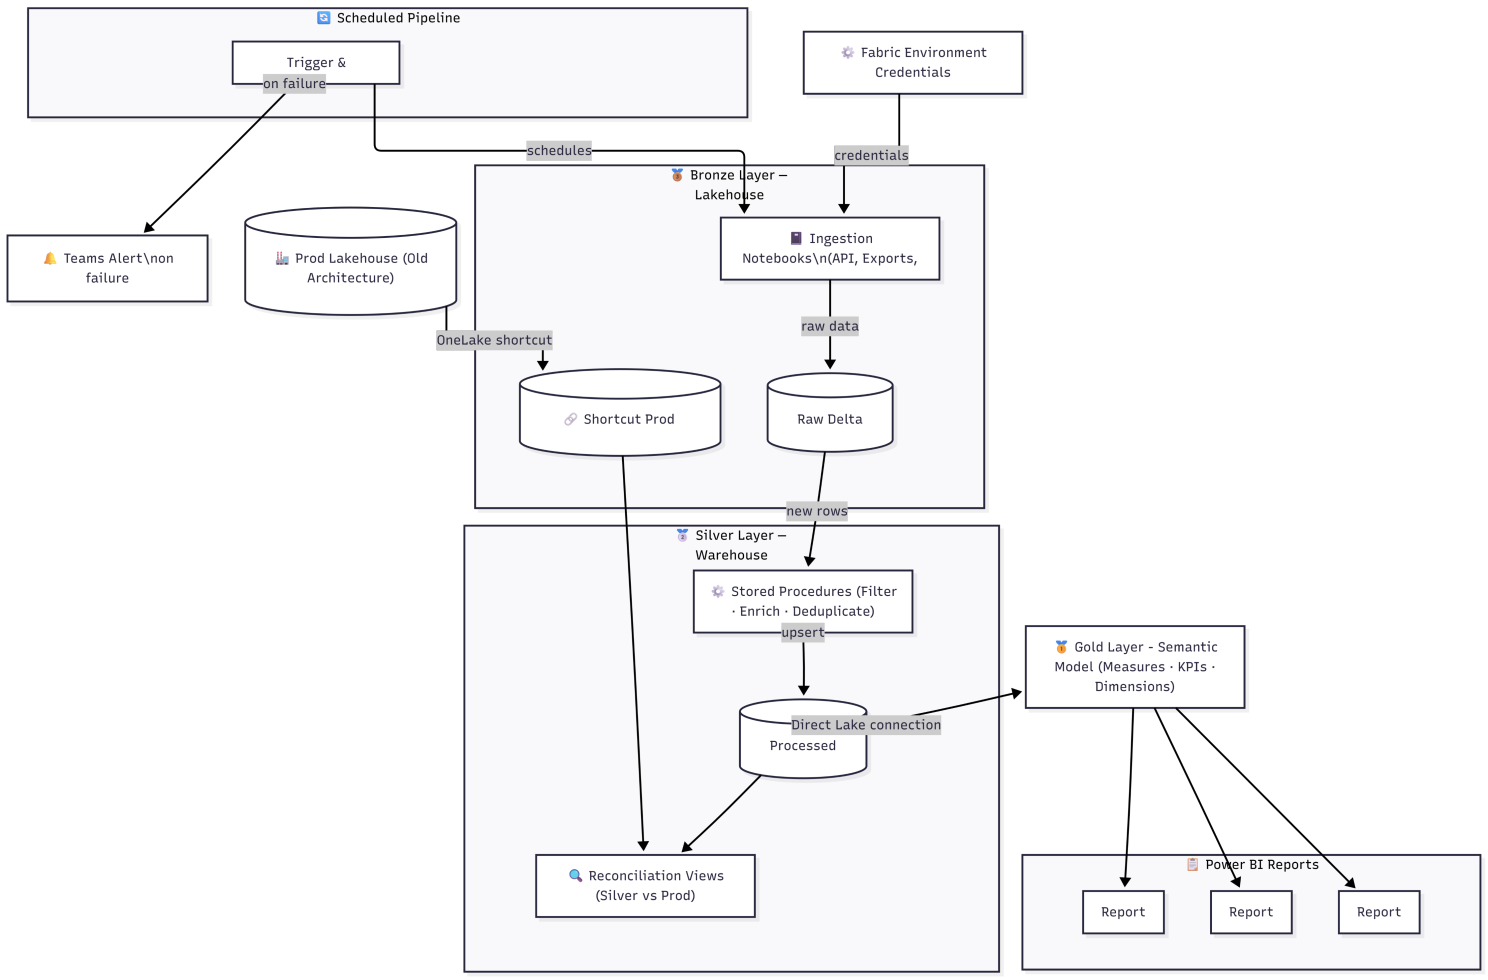
Separare Bronze / Silver / Gold
Credentiale centralizate prin Fabric Environment
Pipeline-uri complet programate și orchestrate
Conexiune Direct Lake, fără actualizare prin import
Toată logica de transformare în proceduri stocate SQL
Istoric complet al datelor brute în Bronze, disponibil pentru reprocesare
Noua arhitectură | Ce am construit
Primul element reconstruit a fost stratul de ingestie. Am rescris de la zero notebook-urile pentru toate sursele de date bazate pe API-uri, concentrându-ne pe separarea clară a responsabilităților: notebook-urile doar preiau și stochează date brute. Orice răspuns al API-ului ajunge într-un tabel Delta împreună cu un timestamp care înregistrează exact momentul sosirii.
Credentialele au fost eliminate complet din notebook-urile individuale și mutate într-un Fabric Environment. Există o singură locație centralizată, referită de toate notebook-urile, iar valorile nu sunt hardcodate nicăieri. Este o schimbare mică, dar cu impact major asupra mentenanței și securității. Regula pentru notebook-uri este să le folosim numai acolo unde o procedură stocată SQL nu ar fi suficientă. Astfel, numărul notebook-urilor a rămas mic, iar responsabilitățile lor au rămas clare.
Silver: proceduri stocate și încărcări incrementale
Odată ce datele brute aveau timestamp în Bronze, stratul Silver putea profita pe deplin de acesta. Pentru tabelele mici, un truncate complet urmat de reinserare la fiecare rulare era simplu și clar. Pentru tabelele mari sau despre care ne așteptam să crească rapid, un model incremental bazat pe timestamp-ul din Bronze evita scanarea întregului tabel sursă la fiecare execuție:
-- T-SQL incremental upsert pattern --
DECLARE @last_timestamp DATETIME2 = (
SELECT ISNULL(MAX([timestamp]), '2020-01-01')
FROM warehouse_dev.silver.target_table
);
MERGE warehouse_dev.silver.target_table AS target
USING (
SELECT * FROM lakehouse_dev.bronze.source_table
WHERE [timestamp] > @last_timestamp
) AS source
ON target.id = source.id
WHEN MATCHED AND source.[timestamp] > target.[timestamp]
THEN UPDATE SET ...
WHEN NOT MATCHED BY TARGET
Modelul este simplu: verifică cel mai recent timestamp deja prezent în tabelul Silver, apoi preia din Bronze doar rândurile mai noi. Stratul Silver rămâne actual fără să atingă datele care nu s-au schimbat.
După popularea tabelelor, am creat view-uri de validare folosind shortcuts OneLake către vechiul workspace de producție. Acestea aduceau fragmente din tabelele legacy în mediul de dezvoltare și le comparau rând cu rând cu noile tabele Silver. Pentru tabelele principale, rezultatele au coincis. În câteva cazuri-limită, stratul Bronze ne-a permis să identificăm rapid originea problemei, să corectăm logica procedurii stocate și să reprocesăm datele.
Gold: semantic model Direct Lake
După curățarea și validarea tabelelor Silver, am reconstruit semantic model. Am ales un semantic model bazat pe Direct Lake pentru date live. Constrângerea esențială a modului Direct Lake modelează întreaga abordare: fără coloane calculate, transformări Power Query sau tabele calculate. Tot ceea ce îi este necesar modelului trebuie să existe deja ca o coloană în stratul Silver.
Am recreat toate măsurile în DAX, am definit relațiile dintre tabele și am reconectat rapoartele la noul workspace. Unele vizualizări au necesitat ajustări minore: denumiri de coloane, formatare și câteva măsuri care se comportau ușor diferit în Direct Lake. Am urmărit și am corectat fiecare diferență. Rezultatul a fost un semantic model și un set de rapoarte care se comportau identic cu cele vechi, construite însă pe o fundație incomparabil mai curată.
Concluzie | Unde trebuie luată decizia?
Cea mai importantă observație arhitecturală nu este una tehnică: este vorba despre locul căruia îi aparțin deciziile. Fiecare transformare realizată în Power Query, într-o coloană calculată DAX sau într-un filtru la nivel de raport este o decizie amânată dincolo de locul ei natural. Modelul medallion mută aceste decizii mai devreme, în SQL, unde pot fi versionate, testate și reutilizate de orice componentă downstream.
Păstrarea datelor brute în Bronze costă aproape nimic într-un cloud lakehouse, comparativ cu beneficiile oferite. Posibilitatea de a reprocesa totul de la zero, fără să apelezi din nou un API și fără să cauți fișierul original, valorează mult mai mult decât spațiul de stocare ocupat.
Iar aceasta a fost doar fundația. O arhitectură curată nu rezolvă singură guvernanța. Cine controlează ce ajunge în producție, când și în ce condiții: aici continuă povestea adevărată.
2. Două medii, o singură sursă de adevăr: dev, prod și tot ce există între ele
Să stabilim contextul. Tocmai ați terminat de reconstruit arhitectura medallion în mediul de dezvoltare. Bronze funcționează fără probleme, procedurile stocate Silver rulează corect, semantic model este conectat prin Direct Lake, iar rapoartele arată exact cum trebuie. Sunteți mulțumit și închideți laptopul.
În dimineața următoare, un coleg deschide un raport și observă că ceva pare în neregulă. Investigați și descoperiți că un notebook fusese modificat, o procedură stocată fusese editată, iar schema unui tabel se schimbase ușor, deși niciuna dintre aceste schimbări nu era destinată producției. Pur și simplu s-a întâmplat, deoarece exista un singur mediu.
Aceasta este partea pe care nimeni nu o menționează atunci când vă prezintă lista de concepte pentru "arhitectura medallion". Straturile sunt importante. La fel de important este însă unde se află aceste straturi și cine le poate modifica.
Problema | De ce nu este suficient un singur mediu?
În vechea arhitectură exista un singur lakehouse. Toată lumea lucra în el. Notebook-urile erau editate live. Poate — poate — ca bună practică, salvați o copie de rezervă pentru orice eventualitate. Dacă nu făceați acest lucru și ceva se defecta în timpul unei rulări, se defecta pentru toată lumea. Dacă testați o nouă abordare de ingestie sau rescriați o transformare, experimentul avea loc pe aceleași tabele din care citeau rapoartele. Acest lucru este acceptabil cât timp proiectul este mic. Nu mai este acceptabil din momentul în care mai multe persoane lucrează cu același cod sau aveți un client care se așteaptă ca dashboard-ul să fie corect luni la ora 9.
Arhitectura medallion ne-a oferit straturi curate. Separarea dev/prod ne-a oferit o delimitare clară în jurul tuturor acestor straturi.
Workspace Dev
Workspace Prod
Locul în care au loc dezvoltarea și testarea
Notebook-uri, proceduri stocate, schimbări de schemă — toate ajung mai întâi aici
Semantic model Direct Lake este construit și validat aici
Alerte Teams la eșec pentru pipeline-urile Bronze și Silver
Pipeline-urile rulează programat, dar schimbările pot fi testate în siguranță
Primește numai ceea ce a fost validat în dev
Fără editare directă — toate schimbările trec prin pipeline-ul de sincronizare
Semantic model și rapoartele sunt implementate prin notebook-uri de deployment (vom reveni asupra subiectului)
Alerte Teams la eșec pentru toate pipeline-urile prod
Sincronizarea poate fi oprită manual sau comutată automat printr-un trigger
Regula este simplă: nimic nu ajunge manual în producție. Totul trece printr-o sincronizare controlată.
Implementarea | Pipeline-ul de sincronizare
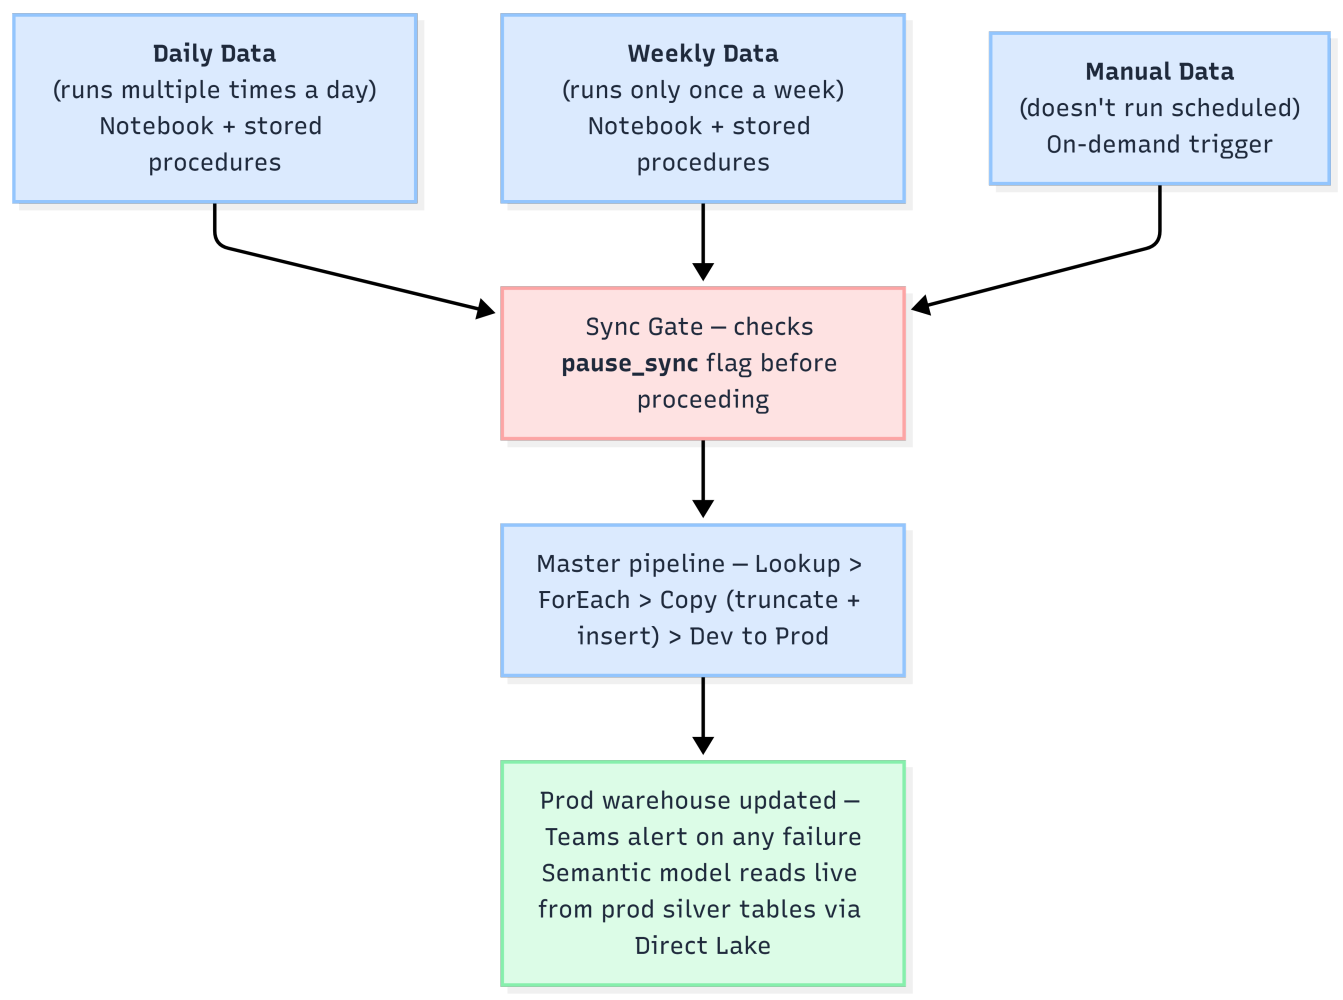
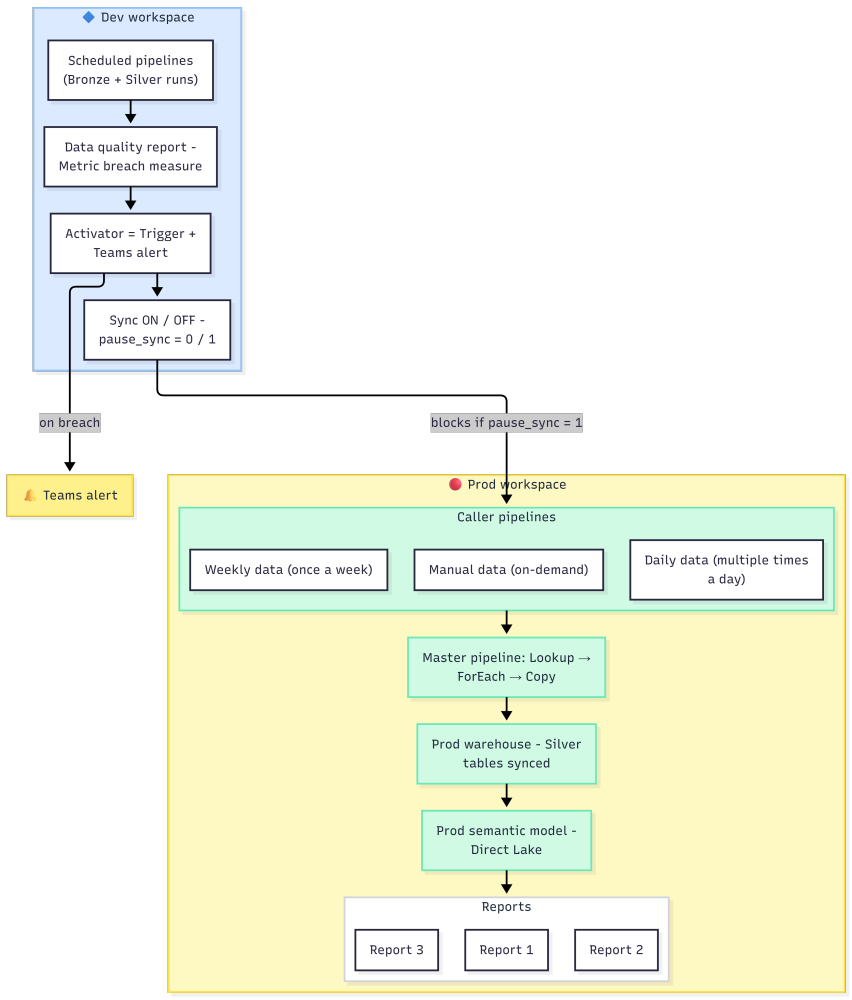
Ideea de bază a sincronizării este simplă. Warehouse-urile dev și prod au aceeași schemă. Atunci când o rulare de pipeline se încheie cu succes în dev, pipeline-ul de sincronizare copiază tabelele Silver rezultate din dev în prod, tabel cu tabel, într-o succesiune controlată.
În spate, sincronizarea folosește o activitate Lookup care construiește o listă dinamică a tabelelor ce trebuie sincronizate, urmată de un ForEach care le parcurge secvențial. Fiecare iterație rulează o activitate Copy cu o strategie truncate-and-insert: tabelul prod este golit, apoi repopulat din dev. Nu există stări parțiale sau merge la nivel de rând între medii, ci doar o copie curată și deterministă.
De ce truncate și insert, nu merge? Pentru că tabelele Silver din dev se află deja în starea validată. Nu există niciun motiv să alegem selectiv ce ajunge în prod: dacă dev este corect, prod trebuie să arate exact ca dev. Truncate și insert exprimă explicit această garanție. "Dar dacă dev nu este corect?" — și această situație este acoperită; vom ajunge imediat la ea.
Fiecare dintre pipeline-urile apelante — Daily Data, Weekly Data și Manual Data — invocă pipeline-ul principal de sincronizare după ce propria rulare se încheie. Pipeline-ul apelant rulează notebook-urile și procedurile stocate, verifică succesul, apoi predă controlul sincronizării. Fiecare pipeline apelant rulează independent de celelalte, preluând numai tabelele care îi aparțin și respectând propriul program. Orice eșec într-un pipeline apelant declanșează o alertă Teams și oprește execuția înainte ca sincronizarea să fie atinsă.
De ce pipeline-uri apelante independente? Nu are sens să transferăm întotdeauna întregul volum de date al stratului Silver din dev în prod. Fiecare pipeline sincronizează numai ceea ce îi aparține, potrivit propriului program: Daily Data rulează de mai multe ori pe zi, Weekly Data o dată pe săptămână, iar Manual Data la cerere.
Poarta de oprire
Este util să aveți un pipeline de sincronizare. Este esențial să îl puteți opri fără să modificați configurația vreunui pipeline.
În warehouse-ul prod există un tabel numit sync_control. Acesta are o singură coloană importantă: pause_sync, un flag de tip bit. Înainte ca pipeline-ul principal de sincronizare să ruleze orice activitate de copiere, verifică acest flag. Dacă este setat la 1, sincronizarea se oprește, ceea ce înseamnă că trigger-ul a detectat o anomalie sau cineva a pus-o intenționat pe pauză. Nu se scrie nimic în prod și nicio eroare nu ajunge la nivelul semantic model sau al raportului. Deoarece primim și o alertă, putem verifica problema la nivelul dev și o putem remedia în timp ce prod continuă să funcționeze corect.
Dar dacă doriți pur și simplu să opriți sincronizarea pentru o lucrare planificată? Flag-ul este comutat printr-un pipeline separat, cu o singură activitate — să îl numim Set Sync State — care folosește o activitate Script pentru a inversa bitul. Nu sunt necesare schimbări de interfață, editări de pipeline sau alte credentiale decât accesul existent la workspace. O rulare oprește sincronizarea, iar alta o reia. 0 înseamnă sincronizare activă, iar 1 înseamnă sincronizare oprită.
-- T-SQL sync control table --
CREATE TABLE warehouse_prod.silver.sync_control (pause_sync BIT NOT NULL DEFAULT 0);
De ce contează în practică? Tocmai ați descoperit o problemă într-o procedură stocată care produce rezultate incorecte pentru un tabel. Pipeline-urile dev continuă să ruleze după program. Fără poarta de oprire, fiecare rulare ar trimite datele incorecte direct în prod. Cu această poartă, comutați flag-ul, reparați procedura, validați rezultatul în dev și reluați sincronizarea când sunteți sigur.
Automatizarea
Comutarea manuală a flag-ului de sincronizare este utilă. Și mai bine este ca acesta să se comute singur atunci când apare o problemă.
În workspace-ul dev, la fiecare rulare de pipeline se populează un tabel cu snapshot-uri privind calitatea datelor. Un raport Power BI construit peste acesta conține o măsură care evaluează dacă vreun indicator esențial s-a deplasat dincolo de un prag acceptabil între cel mai recent snapshot și cel anterior. Dacă regula este încălcată — de exemplu, numărul comenzilor scade peste noapte cu mai mult de x% — se declanșează o alertă Activator.
Mai jos vedeți un trigger real în acțiune. La 09:54, sincronizarea rulează normal: pause_sync = 0. La 09:57, Activator detectează o schimbare a măsurii de calitate a datelor și se declanșează, apelând pipeline-ul Sync ON/OFF cu pause_sync = true. La 10:00, tabelul reflectă noua stare: pause_sync = 1. Trei minute de la detectarea abaterii până la oprirea sincronizării, complet automat, fără intervenție manuală.
Regula Activator rulează la fiecare 15 minute, programată între notebook-urile de ingestie Bronze. Intervalul este intenționat: îi oferă Activator timp să evalueze cele mai recente date și să oprească sincronizarea înainte de următoarea preluare. Dacă detectează o abatere, poarta se închide înainte ca datele noi să ajungă în producție.

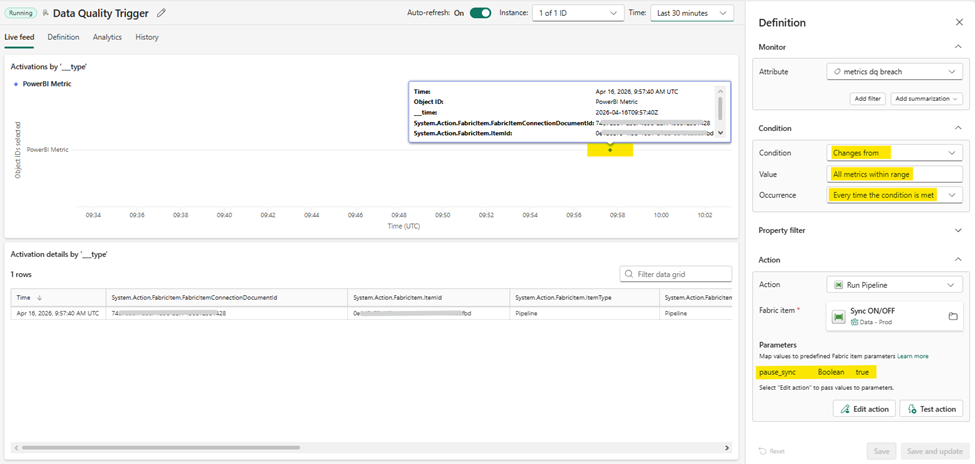

Alerta Activator face simultan două lucruri: trimite o notificare într-un canal Teams, astfel încât persoanele potrivite să fie informate imediat, și declanșează pipeline-ul Set Sync State, care setează automat pause_sync la 1. Sincronizarea se oprește. Prod este protejat. Echipa are timp să investigheze în dev fără ca date incorecte să se propage downstream. Iată fluxul complet, de la rularea unui pipeline dev până la rapoartele prod, cu poarta automată amplasată la granița dintre ele:
Concluzie | Ce oferă în mod concret separarea?
Separarea dev/prod pare o bună practică inginerească evidentă — și chiar este. Dar în contextul Microsoft Fabric, unde granițele dintre dezvoltare și producție pot deveni rapid neclare — aceeași capacitate, același tenant și posibilitatea de a edita ușor ceva live — aplicarea ei necesită o arhitectură deliberată.
Pipeline-ul de sincronizare face din promovarea dev în prod un act conștient și trasabil. Poarta de oprire o face reversibilă și controlabilă, fără ca cineva să modifice sub presiune configurația pipeline-urilor. Trigger-ul automat elimină ultimul punct vulnerabil: chiar dacă nimeni nu urmărește sistemul, poarta se închide singură atunci când datele indică o problemă.
Poarta de sincronizare există tocmai din cauza modului în care funcționează Direct Lake. Orice schimbare care ajunge în stratul Gold este vizibilă imediat în toate rapoartele, inclusiv în cele embedded livrate clienților. Nu există un buffer de actualizare, o fereastră programată sau o întârziere între trimiterea datelor și ceea ce vede clientul pe ecran. Când datele se actualizează, se actualizează și rapoartele.
Aceasta este puterea Direct Lake. Este și riscul său. Un set de date incorect nu rămâne într-o coadă până la următoarea actualizare programată, ci ajunge la clienți în timp real. Poarta de sincronizare este singurul element dintre o eroare de procesare și un raport vizibil clientului.
Arhitectura medallion a oferit datelor straturi curate. Separarea dev/prod a oferit echipei control clar asupra momentului în care aceste straturi intră în producție.
3. Ce arată cifrele: interpretarea Fabric Capacity Metrics înainte și după
Majoritatea oamenilor deschid dashboard-ul Capacity Metrics atunci când ceva este în criză. Noi l-am deschis înainte și după o migrare completă a arhitecturii, iar comparația ne-a arătat de ce a meritat rescrierea.
Microsoft Fabric include un dashboard numit Capacity Metrics. Acesta este disponibil prin instalarea separată a unei aplicații, iar prima dată când îl deschideți veți petrece probabil zece minute întrebându-vă dacă cifrele sunt bune sau rele. Nu există zonă verde sau linie roșie, ci doar bare, secunde CU și un memento discret că interpretarea vă aparține. CU înseamnă Capacity Unit. Este unitatea în care Fabric taxează resursele de calcul. Fiecare rulare de notebook, execuție de procedură stocată, actualizare de semantic model și activitate de pipeline este convertită în secunde CU și totalizată.
În perioada migrării, ambele arhitecturi au rulat pe aceeași capacitate Fabric. Acest lucru ne-a oferit ceva rar: o comparație directă, în paralel, pentru aceeași perioadă de zile. Trebuie menționat de la început că ambele workload-uri au fost active simultan, deci cifrele nu sunt perfect izolate. Tiparele sunt însă suficient de clare pentru a fi relevante.
O introducere rapidă | Ce este, de fapt, un CU?
Înainte să analizăm cifrele, trebuie să înțelegem ce măsurăm. Dashboard-ul afișează peste tot CU (s), iar unitatea este ușor de interpretat greșit.
CU (s) = Capacity Unit-seconds (intensitatea calculului × durata, combinate într-o singură valoare)
CU nu înseamnă "secunde" Litera (s) reprezintă dimensiunea temporală. CU măsoară volumul de resurse de calcul consumate, iar (s) urmărește durata consumului. Împreună exprimă costul total de calcul.
Gândiți-vă la kilowați-oră Așa cum factura de electricitate combină puterea × timpul, CU (s) combină intensitatea calculului × durata. O interogare solicitantă care rulează puțin timp poate costa la fel ca una mai ușoară care rulează mai mult.
Ce măsoară Fiecare rulare de notebook, execuție de procedură stocată, actualizare de semantic model și activitate de pipeline este convertită în secunde CU și totalizată per workspace, element și zi.
Dashboard-ul permite filtrarea după workspace, tip de element, zi și element individual. Odată ce înțelegeți ce priviți, acesta devine o oglindă foarte sinceră a eficienței arhitecturii.
Cifra principală | Cu 42% mai puține CUs pentru același volum de lucru
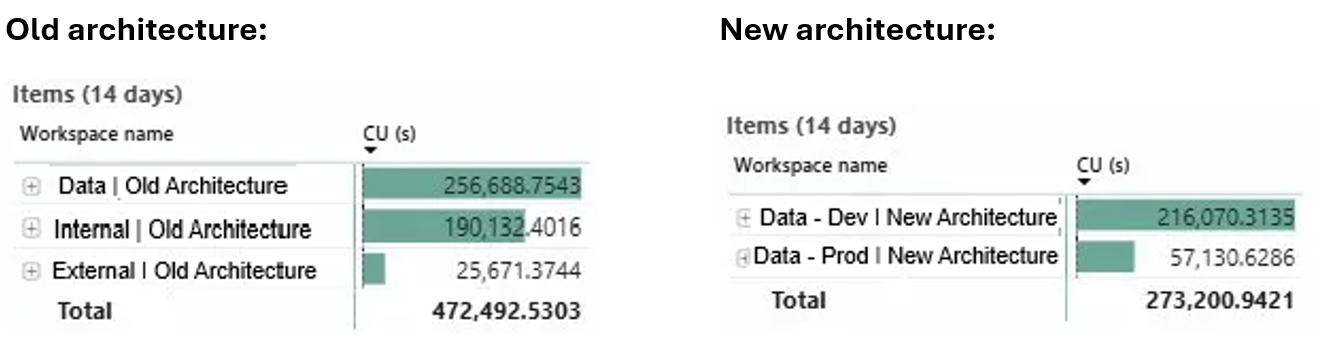
La nivel de workspace, vechea arhitectură a consumat 472,492 secunde CU în cele trei workspace-uri, pe parcursul a 14 zile. Noua arhitectură a consumat 272,200 secunde CU în cele două workspace-uri. Este o reducere de aproximativ 42% pentru o platformă care procesează aceleași surse de date, produce aceleași rapoarte și deservește aceiași utilizatori.
Imaginea de mai jos prezintă defalcarea per workspace așa cum apare în aplicația Capacity Metrics. Workspace-urile vechii arhitecturi sunt Data — lakehouse și notebook-uri — Internal — semantic models și rapoarte interne — și External — semantic models și rapoarte externe. Alături se află workspace-urile Dev și Prod ale noii arhitecturi. Aceeași capacitate, aceeași perioadă, aceleași date.
Defalcarea | Unde s-au consumat efectiv CUs
Valoarea agregată este satisfăcătoare, însă defalcarea per element este locul în care povestea arhitecturii devine vizibilă. Aceștia sunt principalii consumatori din ambele arhitecturi:
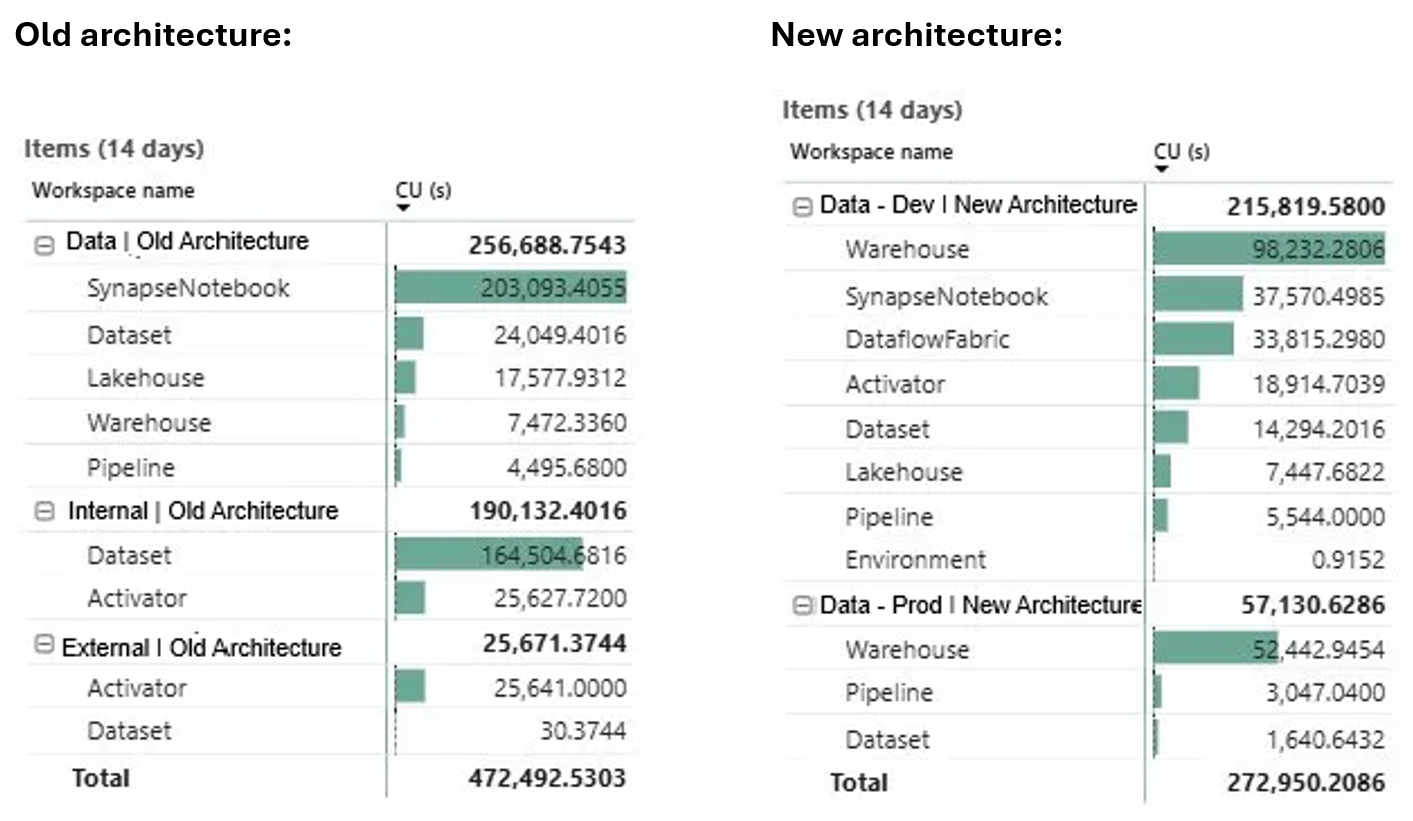
Două cifre ies imediat în evidență:
Problema notebook-urilor
În vechea arhitectură, notebook-urile au consumat 203,093 secunde CU — peste 43% din tot consumul platformei vechi în două săptămâni. Notebook-ul făcea toată munca: citea din API-uri, filtra, elimina duplicatele, transforma, agrega și scria înapoi în lakehouse. Notebook-urile executau cea mai mare parte a procesării grele și consumau CU la fiecare rulare. Iar rulările erau numeroase.
În noua arhitectură, consumul notebook-urilor a scăzut la 37,570 secunde CU. Acum, notebook-urile fac numai ceea ce necesită cu adevărat un notebook: ingestia Bronze din API-uri externe. Toate celelalte operațiuni au fost mutate în proceduri stocate SQL în warehouse. Iar calculul în warehouse este considerabil mai ieftin per operațiune decât calculul în notebook pentru transformări structurate.
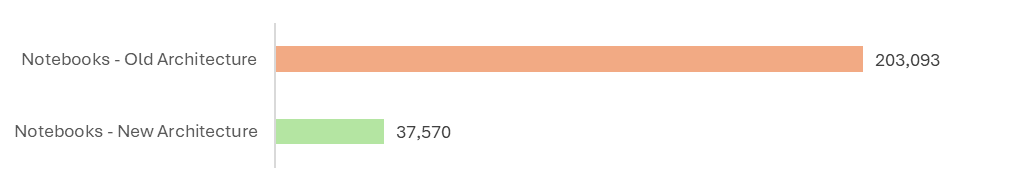
Problema semantic model
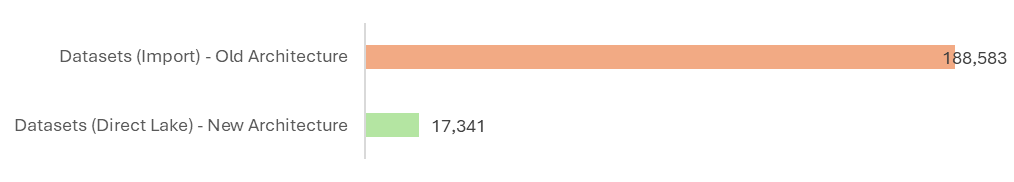
A doua cifră este costul semantic model din vechea arhitectură: 188,583 secunde CU. Modelul în import mode făcea ceea ce fac astfel de modele: rula actualizări complete programate și încărca în memorie, iar și iar, toate datele din SQL Analytics Endpoint, după un program fix.
În noua arhitectură, elementele echivalente de tip dataset au consumat 14,284 secunde CU în dev și 1,640 secunde CU în prod, adică 17,341 în total. Motivul este Direct Lake: când semantic model se conectează direct la tabelele Delta din warehouse, nu mai există nicio actualizare de rulat. Modelul citește date live în momentul interogării. Costul CU masiv al importurilor complete repetate dispare pur și simplu. Vom discuta conexiunile Direct Lake într-un capitol viitor (*subiect în pregătire*).
Concluzie | Ce măsoară indicatorii?
Capacity Metrics nu vă va spune dacă arhitectura este bună sau rea. Vă arată exact pentru ce resurse de calcul plătiți și, dacă știți ce priviți, acest lucru este adesea suficient.
În cazul nostru, două elemente explicau cea mai mare parte a diferenței de cost: notebook-uri care efectuau transformări pe care nu ar fi trebuit să le facă și un semantic model care actualiza date pe care le-ar fi putut citi direct. Dacă puteți, corectați aceste două lucruri: mutați transformările în SQL și semantic model în Direct Lake. Economiile vor urma în mod natural.
4. Cum ajung datele în Power BI: import mode vs Direct Lake
Modalități diferite de a conecta un semantic model la sursa sa de date. Una dintre ele a schimbat complet performanța platformei noastre și volumul de date pe care modelul trebuie să îl păstreze în memorie.
Când construiți un semantic model în Power BI sau Microsoft Fabric, una dintre primele decizii, adesea luată fără să vă dați seama, este modul în care modelul se conectează la date. Această alegere influențează tot ceea ce urmează: performanța interogărilor, costul actualizărilor, memoria ocupată și cât de recente sunt datele atunci când un utilizator deschide raportul.
Există trei moduri de conectare. Cei mai mulți încep cu unul, de obicei import mode, și nu mai reanalizează decizia. Noi am făcut-o, iar diferența a fost suficient de importantă pentru a-i dedica un capitol.
Iată cum funcționează fiecare tip de conexiune:
Import model (Classic)
DirectQuery (Live)
Direct Lake (Fabric-native)
Datele sunt copiate la actualizare în memoria modelului
Interogările rulează rapid pe copia din memorie
Datele sunt actuale numai până la ultima actualizare
Datele noi necesită o actualizare completă
Dimensiunea modelului crește odată cu volumul datelor
Cost CU ridicat pentru fiecare ciclu de actualizare
Modelul nu stochează date — interogările merg direct la sursă
Datele sunt întotdeauna live și actuale
Performanța depinde în totalitate de viteza interogării sursei
Nu există cost de actualizare, dar fiecare vizualizare lansează o interogare
Fiecare interacțiune implică transformarea DAX → SQL
Suport limitat pentru DAX și modelling
Citește direct fișierele Delta Parquet din OneLake
Datele nu sunt copiate și nu există actualizări programate
Viteză apropiată de import mode prin column streaming
Datele se actualizează imediat ce se actualizează tabelul Delta
Modelul ocupă zero memorie
Necesită Fabric — nu este disponibil în Power BI clasic
DirectQuery este răspunsul evident la problema datelor învechite din import mode, dar sacrifică performanța interogărilor și flexibilitatea DAX. De aceea devine nepractic pentru modele complexe, cu multe măsuri și logică calculată. Direct Lake este răspunsul Fabric-native care evită acest compromis: viteză apropiată de import mode, fără copie în memorie și fără ciclu de actualizare.
Pentru cazul nostru de utilizare — un warehouse cu tabele Silver bine structurate, măsuri DAX complexe și nevoia ca datele să fie actuale după ultima rulare a pipeline-ului — Direct Lake a fost alegerea potrivită.
O întrebare frecventă | Un Fabric Warehouse arată ca Delta pentru Direct Lake?
Da! Și merită să înțelegem corect acest lucru, pentru că nu este evident.
Un Fabric Warehouse expune o interfață T-SQL, deci seamănă cu o bază de date SQL tradițională. În spate însă, fiecare tabel creat într-un Fabric Warehouse este stocat fizic ca tabel Delta Parquet în OneLake, același format folosit pentru tabelele Lakehouse. Îl puteți accesa direct în OneLake file explorer, unde sunt vizibile fișierele Parquet și jurnalul Delta.
Direct Lake nu se conectează la Warehouse ca la un motor SQL, ci la fișierele Delta pe care Warehouse le scrie în OneLake. Interfața T-SQL și conexiunea Direct Lake sunt două modalități diferite de a citi aceleași fișiere. De aceea semantic model se poate conecta prin Direct Lake la tabelele din warehouse, chiar dacă noi interacționăm cu ele prin proceduri stocate și T-SQL.
Implicația practică este că, atunci când o procedură stocată rulează și face upsert de rânduri într-un tabel warehouse, actualizează fișierele Delta din OneLake. Conexiunea Direct Lake a semantic model vede imediat fișierele actualizate: fără actualizare și fără pas intermediar. Rularea pipeline-ului reprezintă "actualizarea".
Semantic Models | Înainte și după
Așa arăta traseul datelor în vechea arhitectură și așa arată acum:
Arhitectura veche - date copiate în memorie la fiecare actualizare programată - model = 96.90 MB - 81 de tabele - 700 de coloane
Arhitectura nouă - fără actualizare - date live după fiecare rulare de pipeline - memoria modelului = 0 B - 43 de tabele - 441 de coloane
Ce a arătat Vertipaq Analyzer
Vertipaq (Memory) Analyzer se conectează la un semantic model și raportează exact ce păstrează acesta în memorie, tabel cu tabel și coloană cu coloană. Analiza ambelor modele a produs cele mai contrastante cifre din întregul articol.
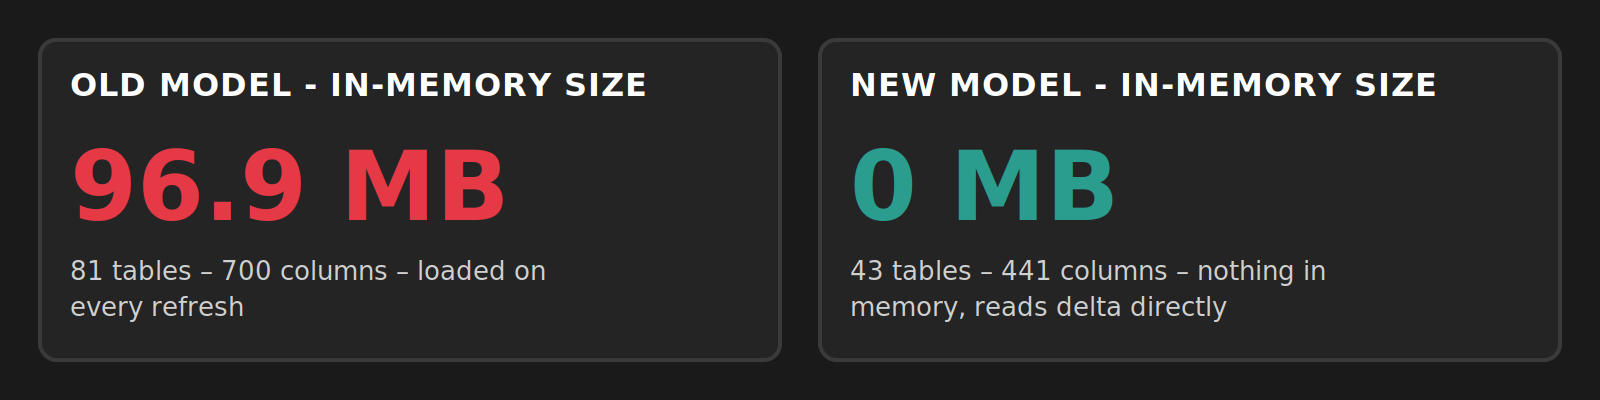
În vechiul model, cele mai grele tabele erau tabelele fact principale, fiecare ocupând individual între 17 MB și 23 MB. Două tabele calculate LocalDateTable, generate automat, mai consumau împreună încă 24 MB. La fiecare actualizare, toate aceste date erau încărcate de la zero din SQL Analytics Endpoint în memoria modelului.
Noul model raportează 0 B. Nu pentru că nu conține date — există aceleași tabele și aceleași rânduri — ci pentru că Direct Lake nu încarcă nimic în model. La momentul interogării, citește la cerere segmente de coloane din fișierele Delta Parquet din OneLake, fără să păstreze vreodată o copie integrală în memorie.
În timpul rescrierii, modelul s-a redus și structural. Trecerea de la 81 de tabele și 700 de coloane la 43 de tabele și 441 de coloane reflectă curățenia realizată odată cu noul strat Silver: tabele intermediare care existau numai pentru Power Query, tabele calculate care compensau coloanele lipsă din sursă și tabele calendaristice duplicate generate automat de funcția auto-date. Toate au fost eliminate, deoarece procedurile stocate Silver gestionează acum logica înainte ca datele să ajungă la model.
Concluzii
Sperăm că articolul v-a oferit câteva idei pentru evaluarea unei arhitecturi Fabric existente sau a uneia noi pe care o construiți.
Este important să evaluați problema pe care încercați să o rezolvați și nevoile utilizatorilor înainte de a alege metodologia potrivită cazului de utilizare. Arhitectura medallion este un model consacrat care a funcționat pentru noi, însă dumneavoastră s-ar putea să aveți nevoie de o abordare diferită.
Suntem interesați să aflăm cum arată configurația dumneavoastră actuală; iar dacă nu aveți încă una, vă putem ajuta să planificați cea mai bună direcție. Discutați cu noi.